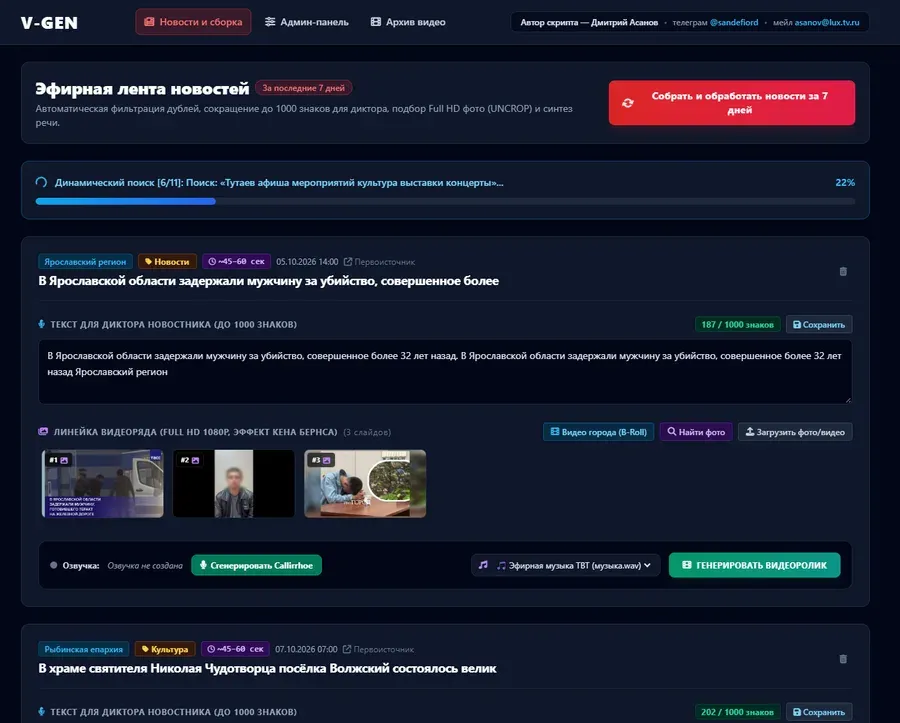
Администратор технической поддержки небольшого регионального телеканала разработал локальный сервис V-GEN для полной автоматизации создания новостных видеосюжетов. Необходимость в инструменте возникла из-за дефицита кадров: после увольнения редактора и оператора сотруднику пришлось самостоятельно вести эфир и готовить контент. Ручной отбор событий из социальных сетей и местных СМИ, написание дикторских текстов, подбор иллюстраций, озвучивание и видеомонтаж отнимали слишком много времени, что и подтолкнуло к созданию автоматизированного решения.
В основе V-GEN лежит связка языковой модели Google Gemini с функцией поиска в реальном времени Grounding with Google Search. В отличие от традиционных парсеров RSS-лент, которые часто ломаются при изменении верстки сайтов, система обращается напрямую к поисковому индексу. Она самостоятельно ищет актуальные инфоповоды за последние несколько дней по заданной географии, сопоставляет факты из официальных источников, фильтрует частные объявления и формирует структурированную подборку по строго заданным критериям.
Модель генерирует текст по телевизионному стандарту объемом от 800 до 1000 знаков, что соответствует читке на 45–60 секунд. Правила промпта включают обязательный динамичный зачин, полное отсутствие канцелярских оборотов и эфирных приветствий, а также автоматический перевод числительных в прописные слова. Для озвучивания применяются нейросетевые голоса Gemini TTS, из которых по умолчанию используется Callirrhoe с хорошей русской фонетикой. Полученное аудио автоматически нормализуется под вещательные стандарты.
Обработка визуальной части осуществляется с помощью Pillow и библиотеки FFmpeg. Любое исходное изображение автоматически адаптируется под стандарт Full HD 1080p: если пропорции отличались от формата 16:9, создается аккуратный размытый задний план, а оригинал центрируется. Для анимации кадров с эффектом панорамирования применяется алгоритм на базе Pillow с субпиксельной точностью, что избавляет трансляцию от неприятного эффекта дрожания при движении виртуальной камеры.
Готовый сервис автоматически высчитывает длительность каждого слайда в зависимости от хронометража сгенерированной речи, расставляет вводные и финальные паузы, накладывает фоновую музыку и вывод эфирного логотипа. В результате создается полностью готовый к вещанию видеофайл. Автор проекта опубликовал исходные наработки в открытом доступе на GitHub, благодаря чему технологию могут использовать другие небольшие локальные студии со схожими задачами.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев