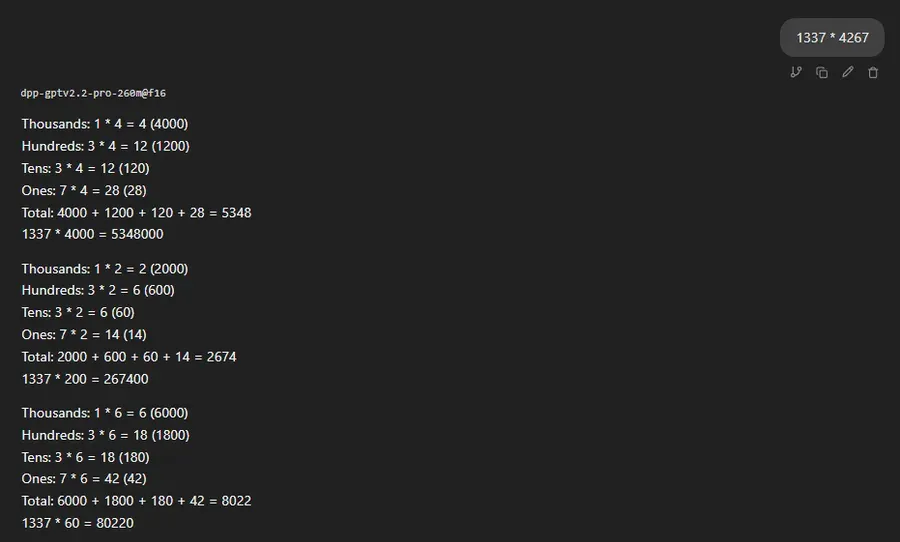
Разработчик под ником dikiyplayerpig создал с нуля собственную языковую модель dpp-gpt 2.2 Pro объёмом 260 миллионов параметров. Главная особенность проекта заключается в том, что обучить нейросеть удалось в домашних условиях на одной потребительской видеокарте NVIDIA GeForce RTX 4060 с 8 ГБ видеопамяти. Автор подчеркивает, что это не просто дообучение чужого готового решения вроде Llama или Mistral, а полноценная разработка всех этапов: от создания собственного токенизатора до предварительного обучения, SFT и подкрепляемого обучения.
В процессе создания версии 2.2 базовая модель получила дополнительные 19 миллиардов токенов, доведя общий объём предварительного обучения до 31 миллиарда. Значительную часть датасета составила специализированная синтетика: математические примеры с поразрядным счётом, сгенерированные скриптами с автоматической проверкой ответов через Python. Для инструкции и диалогов автор использовал синтетические данные, созданные с помощью DeepSeek, потратив на генерацию всего около трех тысяч рублей.
Чтобы повысить качество ответов после этапа SFT, была применена оптимизация с помощью алгоритма GRPO (Group Relative Policy Optimization). Для каждой задачи модель генерировала по восемь вариантов ответов, после чего лучшая траектория подкреплялась. В качестве судьи для оценки сложных текстов и стихов применялась локальная модель Gemma. Интересной находкой стало усреднение весов нескольких финальных чекпоинтов, так называемый «суп моделей», который показал более высокий результат, чем каждый отдельный прогон обучения.
На персональных бенчмарках dpp-gpt 2.2 Pro демонстрирует отличные результаты в пошаговой арифметике, вызове внешних инструментов и генерации верного JSON-кода. В этих дисциплинах она превосходит некоторые компактные аналоги, вроде Falcon-H1-Tiny. Тем не менее, на академических английских тестах вроде HellaSwag модель пока уступает Gemma 3 270M. Автор объясняет это скромным объёмом обучающих токенов по сравнению с крупными корпоративными проектами, тренируемыми на триллионах фрагментов текста.
В настоящее время автор работает над компактной версией 2.2 flash на 140 миллионов параметров и готовит архитектурное обновление 2.3. В новой итерации планируется расширить словарь до 32 тысяч токенов и внедрить локальное внимание, что ускорит работу и обучение на 20-30%. Эксперимент dpp-gpt наглядно показывает, сколь высокоэффективные специализированные навыки можно заложить в миниатюрную нейросеть даже на обычном домашнем оборудовании.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев