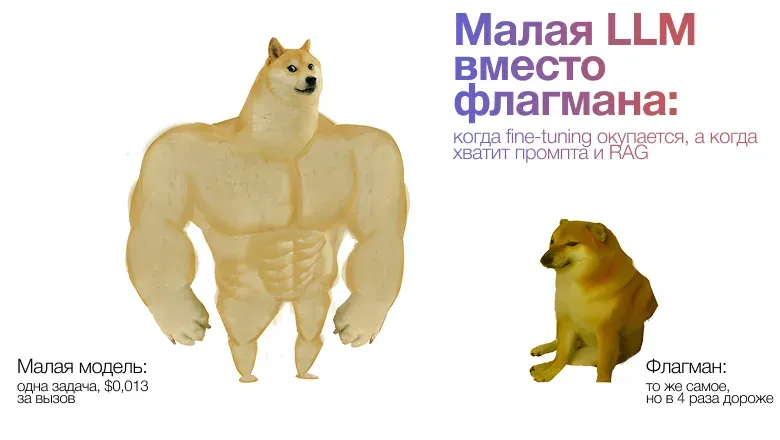
Использование гигантских нейросетей вроде GPT-4 для решения простых и рутинных задач — например, классификации отзывов или проверки формата данных — часто оказывается неоправданно дорогим удовольствием. Это похоже на найм нобелевского лауреата для работы на телефоне в службе поддержки. В индустрии наметился четкий тренд на переход к малым языковым моделям объемом до 10 миллиардов параметров, таким как Gemma, Phi или Qwen. Аналитики из Gartner прогнозируют, что уже к 2027 году компании будут использовать специализированные локальные ИИ-модели в три раза чаще, чем универсальные облачные платформы.
Главные стимулы для такого перехода — колоссальная экономия бюджета и прирост скорости. Ярким примером служит опыт платформы Checkr, которая заменила дорогой API от OpenAI на дообученную открытую модель с 8 миллиардами параметров. Точность распознавания сложных данных у небольшого алгоритма превысила 90%, а расходы компании на инфраструктуру сократились сразу в пять раз. Кроме того, локальный запуск полностью решает проблему конфиденциальности, ведь корпоративная информация больше не отправляется на сторонние серверы и защищена от возможных блокировок учетных записей.
Не менее важным фактором является предсказуемость результатов и быстродействие. Малая модель способна выдавать ответы за доли секунды, тогда как обработка запроса тяжелой универсальной системой может занимать до 15 секунд. Например, в PayPal дообучили небольшую модель с помощью метода LoRA всего на двух сотнях примеров для анализа расшифровок разговоров. В итоге ИИ стал работать вдвое дешевле внешнего API, выдавая при этом абсолютно корректный JSON-формат в 100% случаев, что критически важно для интеграции в автоматические цепочки бизнес-процессов.
Сжатие возможностей большой нейросети в компактный размер происходит с помощью двух основных технологий: дообучения LoRA и дистилляции знаний. Метод LoRA замораживает базовые веса модели и настраивает лишь небольшую вспомогательную матрицу, что позволяет обойтись без дорогостоящих вычислительных кластеров. Дистилляция же работает иначе: малая модель обучается не просто на готовых ответах большой нейросети-учителя, а перенимает саму логику ее рассуждений. Эксперименты Google подтверждают, что обученная таким образом компактная модель может превосходить по качеству гигантов, превосходящих ее по размеру в сотни раз.
Эксперты рекомендуют придерживаться формулы «начинай с большого, специализируй малое». Сначала создается прототип на базе мощной универсальной LLM, что позволяет быстро протестировать гипотезу, зафиксировать типичные ошибки и собрать базу реальных запросов. Каждый успешно обработанный или исправленный вручную диалог превращается в ценный обучающий материал. Когда качественная выборка готова, накопленные данные используются для тренировки узкоспециализированной микромодели, которая будет выполнять конкретную задачу максимально быстро, дешево и эффективно.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев