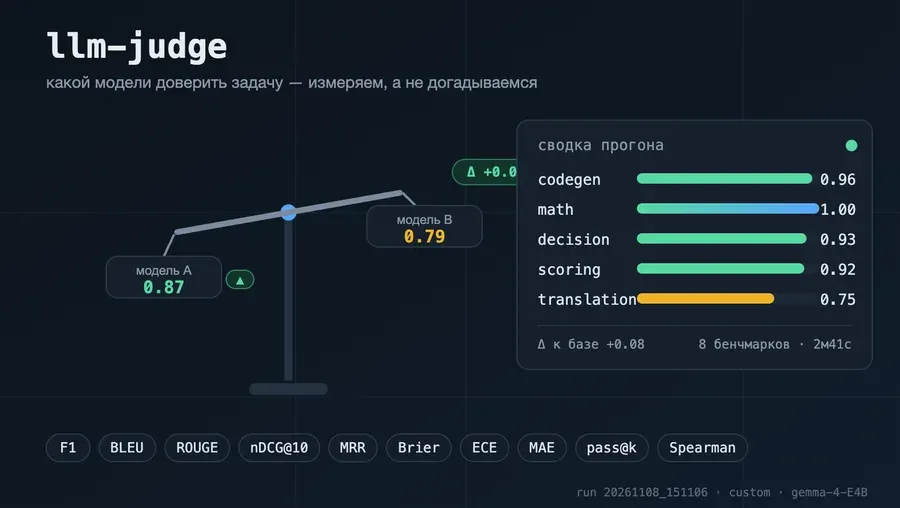
После успешного опыта создания почти автономного агента для разработки пет-проектов, фокус внимания сместился на более узкую и важную техническую проблему: как эффективно выбирать подходящую языковую модель для выполнения конкретных функций. В условиях стремительного развития индустрии, когда новые релизы появляются практически ежедневно, самостоятельный анализ каждой модели становится трудозатратным процессом.
Современный рынок перенасыщен хайповыми анонсами о выходе моделей уровня near-AGI, которые обещают невероятную автономность. Однако для практического использования такие решения часто оказываются избыточными, слишком дорогими и медленными. Большинство подобных обзоров в сети представляют собой субъективные мнения авторов, подкрепленные лишь набором таблиц и картинок, что не позволяет выстроить единую и надежную методологию тестирования.
Основная сложность заключается в том, что универсального «лучшего» решения не существует. Каждая задача требует своего баланса между стоимостью токенов, скоростью генерации и качеством логических рассуждений. Создание агента, который будет выступать в роли независимого арбитра, позволяет автоматизировать этот процесс и уйти от предвзятости, характерной для обычных пользовательских тестов.
Разработка такого инструмента подразумевает создание системы, способной не просто сравнивать ответы, а проводить структурированную оценку по заданным метрикам. Это критически важно для разработчиков, которые интегрируют нейросети в свои продукты и стремятся оптимизировать расходы, не теряя в качестве работы системы. Вместо того чтобы полагаться на маркетинговые заявления, такой подход дает возможность опираться на объективные данные, полученные в ходе автоматизированных проверок.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев