Оценка навыков искусственного интеллекта в написании кода давно вышла за рамки простых алгоритмических задач вроде сортировки массивов или поиска строк. В реальном программировании разработчикам приходится иметь дело со сложными проектами, состоящими из десятков файлов, зависимостей и устаревшего кода. Для проверки автономии ИИ-агентов в таких условиях используется семейство бенчмарков SWE-Bench, созданное на основе реальных задач и открытых репозиториев.
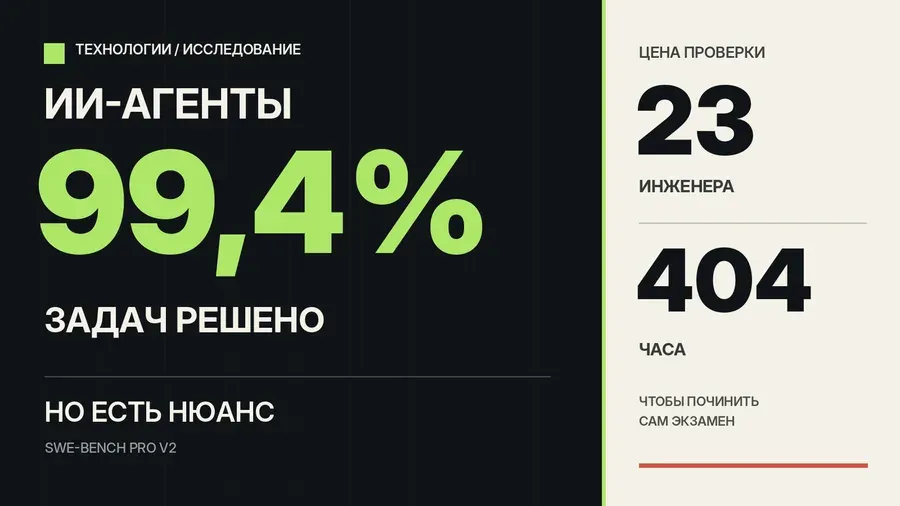
В сентябре был представлен обновленный набор тестовых заданий SWE-Bench Pro V2, в котором современные нейросети показывают поразительные результаты. На публичных наборах данных лучшие ИИ-агенты смогли успешно справиться с 99,4% предложенных задач. Однако за этими впечатляющими цифрами скрывается огромная работа исследователей по исправлению самого инструмента тестирования.
Как выяснилось, предыдущие версии бенчмарка содержали множество системных ошибок. Некоторые тесты отклоняли полностью корректный и работоспособный код нейросетей, тогда как другие, наоборот, принимали ошибочные или неполные исправления. Кроме того, в отдельных заданиях модели могли воспользоваться готовыми решениями из открытого доступа. Чтобы устранить эти изъяны, команде из 23 инженеров потребовалось суммарно 404 часа на ручную проверку и корректировку заданий.
Проблема достоверности бенчмарков остаётся ключевой для всей индустрии искусственного интеллекта. Без объективной системы контроля высокие показатели моделей в тестах могут вводить разработчиков в заблуждение, не отражая реальную готовность ИИ к работе над коммерческими программными продуктами. Исправление SWE-Bench Pro показывает, что создание качественных тестов для оценки ИИ-инженеров требует не меньших усилий, чем разработка самих нейросетей.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев