Первая публичная демонстрация машинного перевода состоялась еще в 1954 году во время совместного эксперимента Джорджтаунского университета и компании IBM. Систему запустили на мейнфрейме IBM 701, который занимал целую комнату. Операторы вводили фразы на русском языке с помощью транслитерации на перфокартах, поскольку компьютер не поддерживал кириллицу. Машина успешно справилась с переработкой шестидесяти заранее подготовленных предложений, однако этот успех был лишь созданной вручную иллюзией.
В основе работы раннего алгоритма лежали шесть базовых правил и ограниченный словарь, содержащий около 250 корней и окончаний. Каждому слову сопоставлялись жестко запрограммированные коды, указывающие, какой из двух вариантов перевода выбрать и в каком порядке расставить слова в предложении. Алгоритм не анализировал смысл текста, а лишь слепо следовал логике, подобранной инженерами под конкретные примеры. Как только текст выходил за рамки тестовой выборки, переводчик полностью терял работоспособность.
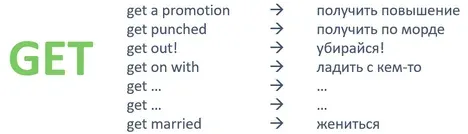
На протяжении тридцати лет ученые и программисты пытались заставить компьютеры переводить тексты с помощью усложнения грамматических сводов и расширения словарей. Крупные компании тратили огромные бюджеты на привлечение лучших лингвистов, но добиться качественного результата так и не удалось. Естественный язык оказался слишком гибким и контекстным: даже одно английское слово вроде get имеет сотни значений, а описать всю структуру правил и исключений строгим кодом оказалось невыполнимой задачей.
Перелом в индустрии произошел в 1990-х годах с приходом статистического подхода. На соревнованиях 2005 года молодая система от Google обошла все традиционные разработки, хотя в команде создателей не было экспертов по арабскому или другим языкам. Алгоритмы прекратили искать лингвистический смысл и переключились на анализ огромных массивов уже переведенных текстов, таких как документы ООН и Евросоюза. Программа рассчитывала вероятность совместной встречаемости слов и фраз в одинаковом окружении, собирая статистические словари абсолютно автоматически.
Сегодня на смену статистике пришли нейросети с архитектурой трансформеров, которые лежат в основе современных сервисов перевода. Такие системы обрабатывают предложение или целый документ целиком, считывая контекст и стилистику оригинала. Вместо пословного сопоставления нейросеть сначала формирует внутреннее представление о смысле всего текста, а затем заново воссоздает его на целевом языке. Это позволило автоматическому переводу достичь качества, сравнимого с работой профессиональных переводчиков-людей.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев