Интеграция искусственного интеллекта в образовательные продукты стала массовым трендом, однако оценка качества работы умных помощников до сих пор остается сложной инженерной задачей. Создатели цифровых платформ часто пытаются заменить человеческий контроль автоматизированными проверками, чтобы оперативно выбирать подходящие языковые модели и корректировать системные промпты. Однако на практике традиционные методы тестирования программного обеспечения плохо справляются с нюансами поведения нейросетей.
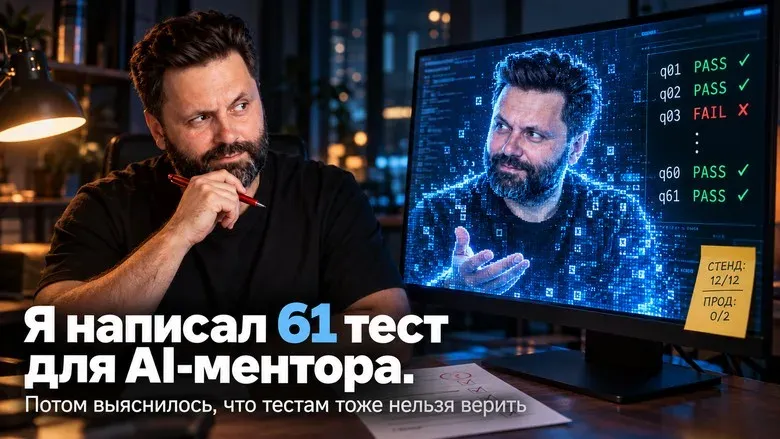
При проектировании ИИ-ментора для обучающего сервиса разработчики столкнулись со специфическими требованиями к логике его ответов. В отличие от стандартного репетитора, цифровой ассистент должен не просто давать правильные решения задач, а корректно направлять студента, указывая на ошибки и подталкивая к самостоятельным выводам. Для контроля качества был создан специальный стенд из 61 автоматического теста, который анализировал контекст уроков, текущий прогресс пользователя и его последние попытки решения.
В процессе эксплуатации тестового стенда выяснилось, что доверять его метрикам нельзя. Автоматическая система систематически выдавала ложноположительные и ложноотрицательные результаты. Например, стенд засчитывал как успешные оборванные ответы ИИ или пропускал случаи, когда нейросеть вместо подсказки выдавала готовый код, но с измененными названиями переменных. При этом обоснованный отказ модели отвечать на некорректный вопрос система часто фиксировала как ошибку.
Дополнительной проблемой стало разительное расхождение между поведением модели на тестовом стенде и в реальной рабочей среде. На синтетических сценариях ассистент демонстрировал близкие к идеальным показатели, однако при взаимодействии с настоящими пользователями на тот же класс вопросов выдавал совершенно иные ответы. Это создало ложное ощущение стабильности сервиса, которое быстро разрушилось после запуска на реальную аудиторию.
Данный случай наглядно демонстрирует, что традиционные подходы к тестированию программного обеспечения требуют серьезной переработки при работе с генеративным ИИ. Разработчикам приходится искать новые метрики и комбинировать автоматические проверки с непрерывным выборочным аудитом ответов вручную. Без глубинного анализа контекста любые синтетические тесты рискуют стать источником опасной иллюзии надежности.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев