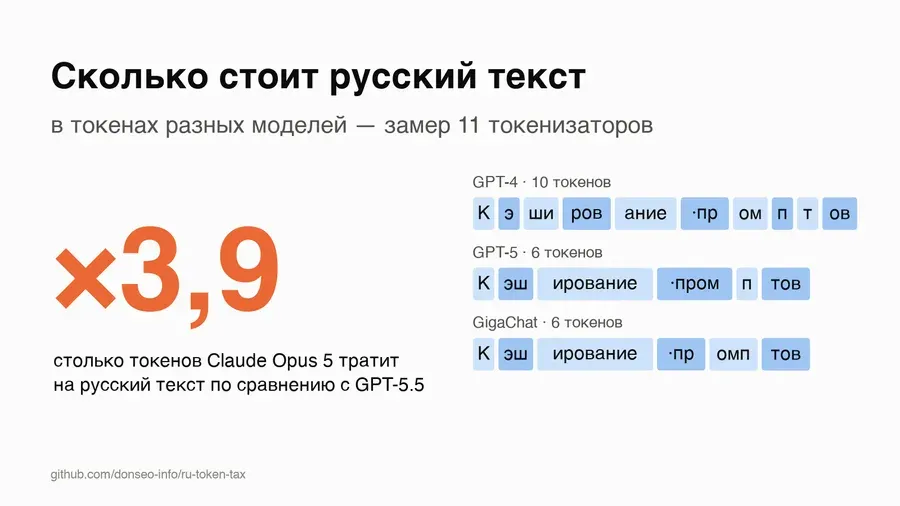
Разработчики и компании, использующие искусственный интеллект для работы с русским языком, столкнулись с неожиданной проблемой ценообразования. Сравнительный анализ работы популярных языковых моделей показал, что обработка одного и того же русскоязычного текста в Claude Opus 5 обойдется почти в четыре раза дороже, чем в GPT-5.5. Причина кроется не в базовых тарифах провайдеров, а в архитектурных особенностях токенизаторов — специальных алгоритмов, которые разбивают текст на фрагменты для последующей обработки нейросетью.
Для понимания проблемы важно знать, как большие языковые модели оценивают объем информации. Они оперируют не символами или словами, а токенами — смысловыми частями слов или отдельными буквами. Провайдеры берут плату именно за количество использованных токенов. Исторически сложилось так, что токенизаторы западных ИИ-лабораторий оптимизированы под английский язык, где один токен обычно равен четырем символам. С кириллицей ситуация иная: из-за неэффективного сжатия русский текст часто дробится на гораздо более мелкие части, что раздувает итоговый счет за использование API.
В ходе независимого тестирования одиннадцати различных токенизаторов на параллельных текстах выяснилось, что Claude Opus 5 расходует в среднем в 3,9 раза больше токенов на обработку кириллицы, чем GPT-5.5. В худших сценариях модель от Anthropic тратит по одному токену на каждый символ русского текста. В то же время OpenAI значительно улучшила работу своей новой модели с русским языком. На этом фоне отечественные альтернативы выглядят еще выгоднее: локальные модели YandexGPT и GigaChat оптимизированы для кириллицы настолько хорошо, что один токен в них может вмещать до пяти символов. В результате русский текст для них оказывается в обработке даже короче и дешевле английского.
Эта разница кардинально меняет реальную стоимость интеграции искусственного интеллекта в коммерческие продукты. Даже если номинальная стоимость одного токена у двух конкурирующих систем одинакова, итоговый чек для русскоязычного проекта на базе Claude окажется непомерно высоким. Исследователи также обратили внимание на особенности подсчета метрики использования ресурсов у сторонних API-агрегаторов. Некоторые сервисы некорректно транслируют расходы клиентов, что может приводить к дополнительным скрытым переплатам при работе с неоптимизированными для кириллицы моделями.
Для разработчиков это означает необходимость проводить предварительные расчеты стоимости не по прайс-листам компаний, а на основе реальных тестов токенизации собственных текстовых массивов. Выбор модели без учета специфики языка может увеличить операционные расходы бизнеса в разы. В условиях жесткой конкуренции на рынке генеративного ИИ эффективность токенизатора становится одним из ключевых факторов выбора технологического стека для локальных рынков за пределами англоязычного сегмента.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев