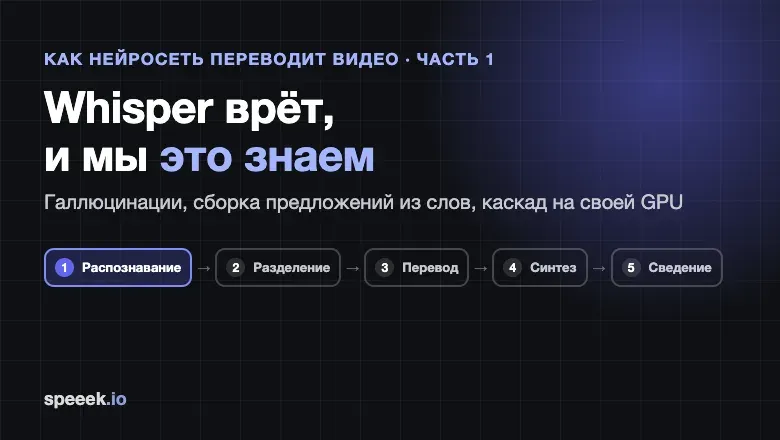
Создатель сервиса автоматического дубляжа видео поделился опытом многолетней работы с популярной нейросетью Whisper от компании OpenAI. Автор запустил проект в 2022 году, рассчитывая быстро завершить разработку, однако спустя годы конвейер по-прежнему сталкивается с теми же архитектурными проблемами. За это время система обработала более девяти тысяч задач, что позволило детально изучить все слабые места технологии распознавания речи.
Первый этап обработки любого видеоролика заключается в преобразовании звуковой дорожки в текст с точными таймкодами и разделением на спикеров. На этом пути Whisper регулярно допускает ошибки, которые автор называет галлюцинациями. В статье подробно разбираются три основных типа таких сбоев и приводятся примеры кода для их обхода. Например, разработчикам приходится полностью отказываться от стандартных сегментов нейросети и собирать итоговые предложения самостоятельно.
Серверная архитектура проекта построена на собственной видеокарте с настроенным каскадом алгоритмов и запасными выходами на случай сбоев. В процессе работы выяснились специфические баги, такие как потеря значительных фрагментов речи при обработке записей на хинди. Кроме того, система сохраняет фундаментальное техническое ограничение: она не умеет корректно распознавать речь двух людей, говорящих одновременно.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев