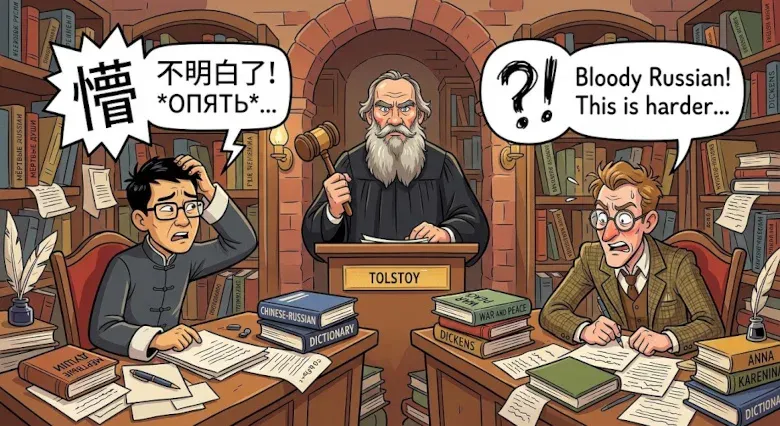
Оценка качества машинного перевода долгое время оставалась субъективной задачей, зависящей от вкусов проверяющего. Разработчики создали стандартизированный бенчмарк для проверки англо-русского художественного перевода, который встроен в конвейер BookTrans и исключает человеческий фактор. За основу был взят рассказ О. Генри «The Skylight Room», перенесенный в современные реалии и содержащий около трех тысяч слов.
В текст специально внесли сто ловушек по двенадцати категориям, включая ложные друзья переводчика, многозначные слова, особенности согласования родов и специфические идиомы. Например, в тексте есть врач, чей пол раскрывается лишь спустя шесть абзацев, что заставляет модель заранее определиться с грамматическим родом глаголов. Другой пример — слово fair, которое встречается в разных значениях как ярмарка, светлая кожа и меткий выстрел.
В отличие от старых методов, где нейросеть-судья выставляла общую оценку на свой вкус, новый бенчмарк использует точечный список контрольных точек. Судья получает ключ с ответами по каждой ловушке и дает бинарный ответ: пройдена она или провалена. Итоговый балл рассчитывается автоматически по количеству пройденных точек с учетом штрафов за отсебятину, пропущенные фрагменты или использование иероглифов.
Для повышения точности результатов каждый текст переводится и проверяется трижды, после чего система вычисляет медиану и разброс баллов. Тестирование показало, что лучшие результаты сегодня демонстрируют передовые языковые модели Gemini и GPT, тогда как китайские аналоги вроде DeepSeek отстают незначительно, но уступают флагманам в деталях.
Открытый репозиторий и зашифрованный ключ ответов предотвращают утечку тестовых данных в обучающие выборки нейросетей. Новый инструмент позволяет разработчикам и переводчикам объективно сравнивать разные модели по техническим параметрам, экономя время на ручном чтении и сравнении вариантов перевода.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев