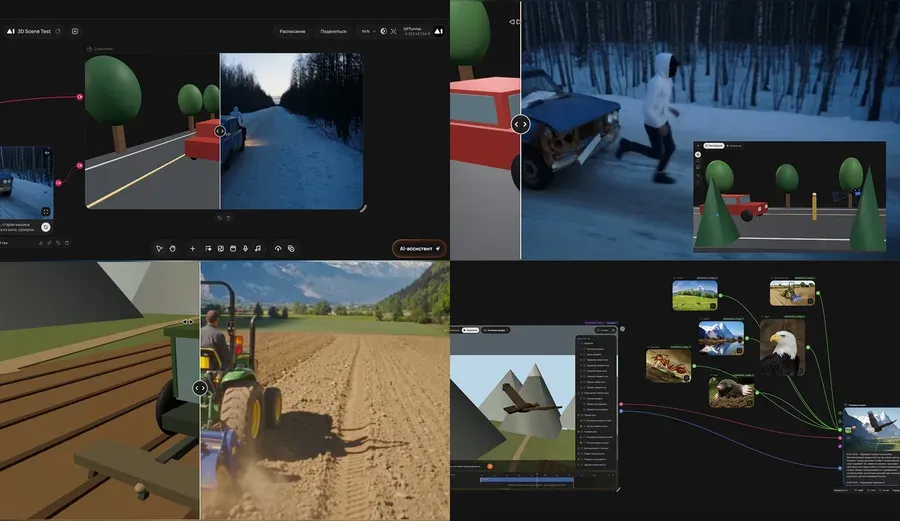
Видеомодели искусственного интеллекта часто отклоняются от заданного текста, придумывая собственный сюжет и хореографию. Такой «творческий» отклик усложняет работу продюсеров, которым нужен точный контроль над камерой, таймингом и движениями персонажей. Илья Трикоз, сооснователь проекта GPTunneL, рассказал на Хабре о новой функции, призванной устранить эту проблему.
Новый узел под названием «3D‑сцена» интегрирован в визуальный конструктор воркфлоу GPTunneL. Он позволяет автоматически собрать простую сцену из базовых примитивов – кубов, сфер и плоскостей, разместить виртуальные камеры и задать их параметры. По готовой композиции система генерирует статический рендер‑референс, который затем используется как точный шаблон для дальнейшей генерации. Пользователь может задавать положение источников света и выбирать фон, что делает референс более приближённым к финальному видеорендеру.
Модели видеогенерации Seedance 2.5 и Hailuo H3 умеют принимать такой визуальный референс и воспроизводить его движения кадр за кадром. Камера следует заданному пути, тайминги совпадают, а анимация объектов повторяет исходные каты без отклонений. Кроме того, модель сохраняет последовательность ключевых кадров, что упрощает последующее редактирование таймингов без повторного обучения. Таким образом, каждый элемент – от ракурса до скорости вращения – становится полностью предсказуемым и фиксируемым.
Подход избавляет от бесконечных попыток «уговорить» ИИ при помощи текста: вместо слов разработчик «показывает» желаемую сцену кубиками и линиями. Любой шаг можно быстро изменить – переместить объект, скорректировать угол камеры или изменить длительность – и мгновенно получить обновлённый референс. Это ускоряет прототипирование, снижает нагрузку на вычислительные ресурсы и упрощает совместную работу над видеопроектами. Такой уровень контроля особенно ценен для рекламных роликов и учебных материалов, где каждый кадр проверяется на соответствие бренд‑гайдам.
Техника визуального подсказания вписывается в растущий тренд мультимодального управления генеративными моделями, когда текст дополняется графикой, 3D‑моделями и звуком. Ожидается, что такие решения станут стандартом в профессиональных пайплайнах создания AI‑видео, позволяя студиям и независимым креативщикам получать стабильный результат без компромиссов между креативностью и контролем. В ближайших обновлениях планируется поддержка более сложных геометрий и интеграция с популярными 3D‑пакетами, что расширит возможности кастомизации.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев