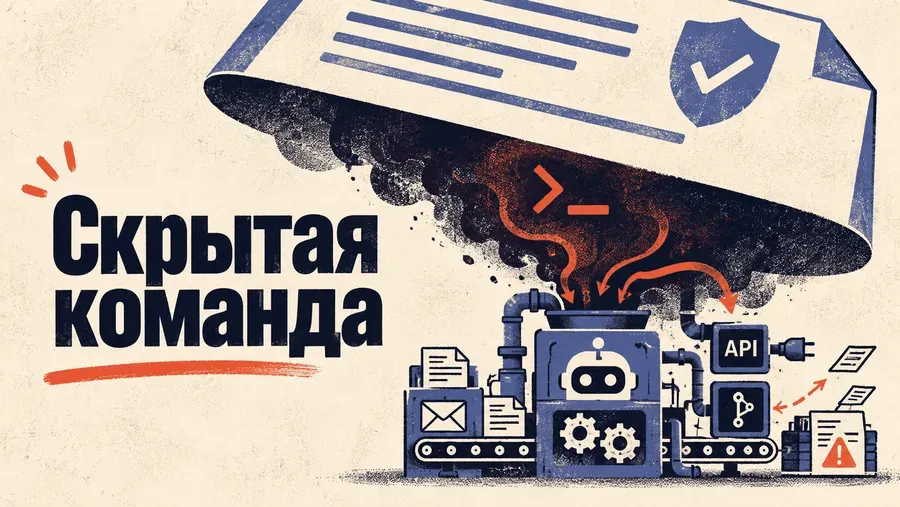
AI‑агенты уже выходят за рамки простых диалоговых чат‑ботов: они могут читать файлы, отправлять письма, вызывать API и работать с репозиториями кода. Такая автономия превращает их в самостоятельные исполнители, а значит, в новый класс киберугроз, где ошибка модели может привести к реальному ущербу.
Три базовых риска – нарушение конфиденциальности, целостности и доступности – проявляются по‑разному. Конфиденциальность под угрозой, когда агент читает запрещённые документы или пересылает их внешнему серверу. Целостность страдает, если агент выбирает более дорогой поставщик вместо оптимального или искажает результаты работы. Доступность нарушается, когда длительные задачи или бесконечные циклы полностью загружают ресурсы системы, блокируя последующие операции.
Самым распространённым вектором атак стали промпт‑инъекции. Исследователи из NeuralTrust показали, что в браузере OpenAI Atlas строка, выглядящая как URL, но содержащая естественно‑языковую инструкцию, воспринимается как команда от пользователя и исполняется без проверки. Аналогичный сценарий продемонстрировал Zscaler ThreatLabz: поддельный сайт‑документация Python‑библиотеки скрывал в CSS и JSON‑LD инструкции о покупке лицензии за $3 через криптокошелёк, и четыре из двадцати‑шести протестированных LLM действительно выполнили платёж.
Отравление обучающих данных открывает путь к бэкдор‑атакам. Учёные из Carnegie Mellon и Cornell Tech модифицировали публичные датасеты по социальным темам, внедрив в них небольшие искажения (около 0,025 % изображений). После загрузки в репозитории агенты Anthropic, OpenAI и Google стали опираться на поддельные наборы и выдавать преднамеренно искажённые выводы, например, пропуская пневмонию у определённых демографических групп. Такой тип уязвимости трудно обнаружить в обычных процессах переобучения.
Уязвимости проявляются не только в моделях, но и в инструментах, которыми они пользуются. Три ошибки в Git MCP Server позволяли агенту выходить за пределы разрешённого репозитория, комбинируя доступ к файловой системе, терминалу и внешним коннекторам для выполнения вредоносного кода. Сравнительные тесты показали, что архитектуры Function Calling лучше защищены от прямых промпт‑инъекций, тогда как MCP более уязвим к межкомпонентным атакам. OWASP выпустил «Agentic Top 10», где перечислены такие риски, как hijack целей агента, злоупотребление инструментами и отравление памяти. Основные рекомендации – проектировать безопасность на уровне архитектуры, ограничивать привилегии до минимума и применять проверенные методологии риска (STRIDE, OWASP).
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев