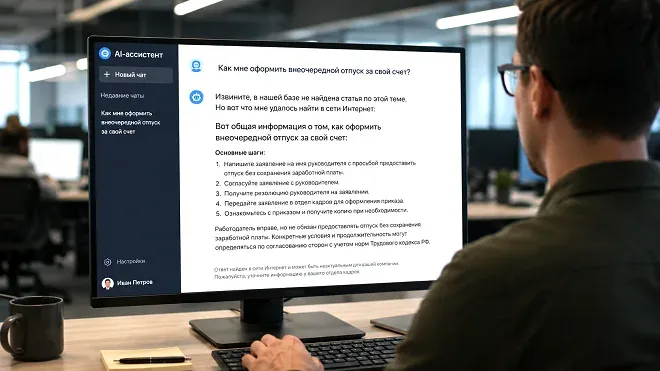
Многие крупные компании в этом году инвестировали в AI‑ассистентов, обещая сотрудникам мгновенный доступ к корпоративным инструкциям и процессам. Через несколько недель после демонстраций выясняется, что большинство работников либо игнорируют новые инструменты, либо получают от них противоречивые и устаревшие рекомендации, что подрывает доверие к технологии.
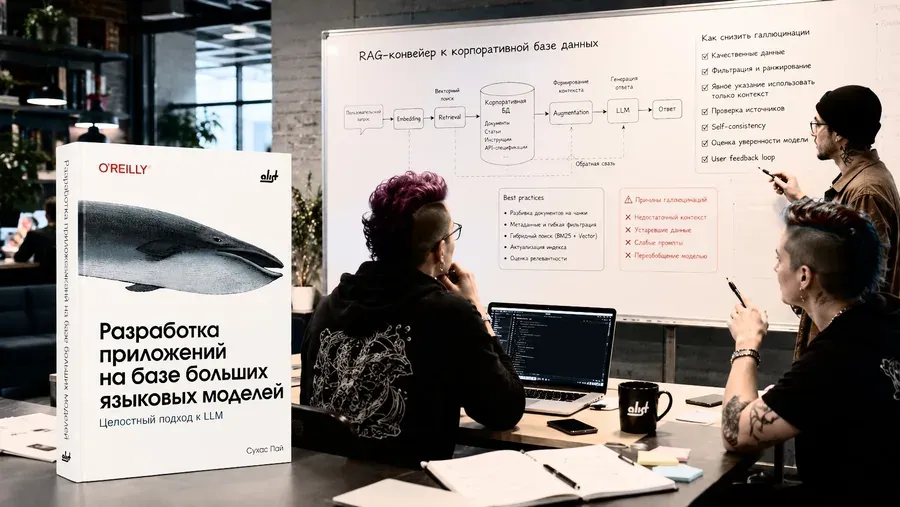
Сам по себе языковой модельный движок умеет писать код, переводить тексты и объяснять физические явления, но в корпоративных условиях ей недостает специфических знаний о правилах, продуктах и терминологии компании. Чтобы AI‑агент мог отвечать на рабочие запросы, его необходимо «подкормить» внутренней базой, однако в реальных хранилищах часто встречаются неактуальные инструкции, дублирующие версии файлов и документы в неструктурированных форматах, что делает даже продвинутый RAG‑подход бесполезным.
Анализ типовых провалов выделил пять ошибок. Первая – отсутствие единой схемы оформления документов: в одном файле шаги описаны списком, в другом – сплошным абзацем, а в третьем – в таблице, из‑за чего поиск фрагментов разбивается на бессвязные чанки. Вторая – отсутствие метаданных и разметки ключевых сущностей (правило, исключение, роль, версия), из‑за чего система видит только сырой текст. Третья – попытка загрузить сразу все файлы в векторную базу, включая черновики и устаревшие справочники. Четвёртая – отсутствие приоритетов источников: при конфликте ответов модель не знает, какой документ считать каноническим. Пятая – создание одного универсального ассистента, который пытается обслуживать бухгалтеров, логистов и продавцов, не учитывая их разный контекст запросов.
Чтобы избавиться от этих пробелов, компании должны сначала согласовать структуру всех инструкций (условия → порядок действий → исключения → ответственные), затем добавить к каждому файлу метки: дата выпуска, версия, статус актуальности. После этого в векторную базу загружают только проверенные источники – утверждённые регламенты, официальные листы продуктов и актуальные политики. Для каждого типа запроса назначается канонический документ, к которому модель обращается в первую очередь, а при отсутствии достоверных данных получает разрешение ответить «Я не знаю» вместо уверенной «галлюцинации».
После запуска такой системы появляется обратная связь: сотрудники оценивают полезность ответов, а аналитика фиксирует, какие запросы остаются без ответа или вызывают ошибки. Эти данные позволяют регулярно проводить аудит знаний, удалять дубли и обновлять метаданные, что по некоторым оценкам снижает частоту ошибок с 25 % до почти нуля. Правильно построенный процесс управления знаниями превращает AI‑ассистента из громкого рекламного трюка в надёжный инструмент поддержки бизнес‑процессов.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев