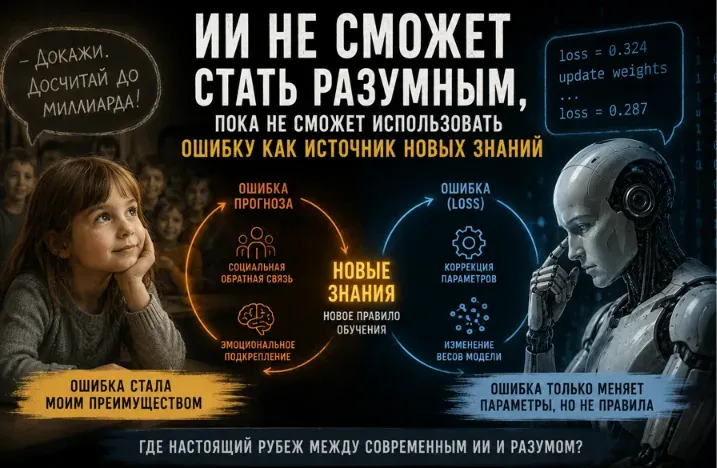
Нейросети сегодняшнего дня кажутся невероятно умными: они пишут стихи, водят автомобили, распознают лица и даже ведут переговоры. Но при ближайшем рассмотрении оказывается, что их «разум» работает по чёткому алгоритму оптимизации, а не по тем принципам, которые лежат в основе человеческой мысли. Даже когда ИИ ошибается, он не испытывает ни стыда, ни радости, ни осознания собственной несостоятельности — он просто корректирует параметры, чтобы в следующий раз выдать более «правильный» результат. Именно эта принципиальная разница мешает современным системам приблизиться к пониманию ошибки как источника нового знания, а значит, и обрекает их на поверхностное обучение без глубины опыта.
Сегодня основным инструментом обучения ИИ остаётся числовая оптимизация. Не важно, идёт ли речь о функции потерь (loss), о системе вознаграждения (reward) или о человеческих оценках (RLHF) — все эти механизмы так или иначе подчиняются одной логике. Алгоритм получает числовой сигнал, который показывает, насколько его ответ далёк от идеала, и на основе этого сигнала корректирует веса нейронной сети. Задача при этом всегда одна: минимизировать «ошибку» или максимизировать «вознаграждение». Но человек в подобной ситуации поступает иначе. Ошибка для него — это не просто цифра, это точка, с которой начинается переосмысление: почему она возникла, какую новую информацию она несёт, как изменить свои действия в будущем. Нейросеть же не способна на такое. Она не «переживает» провал, а лишь становится немного точнее в рамках заданной задачи.
Эта проблема лежит в основе одного из главных ограничений современного искусственного интеллекта. Даже самые передовые модели, такие как GPT-4 или Midjourney, не могут выйти за рамки оптимизационного подхода. Они не способны к рефлексии, к осознанию собственных ошибок как части процесса познания, к превращению неудач в инструмент для будущих достижений. Возможно, именно поэтому нейросети так хорошо решают узкие задачи, но не способны на обобщение и творческое мышление. Ведь чтобы творить, нужно не только знать правила, но и нарушать их, а затем извлекать уроки из этих нарушений.
Пока что единственным способом улучшить ситуацию исследователи видят в разработке новых архитектур, которые могли бы имитировать человеческие механизмы обучения. Например, системы, способные не просто корректировать ошибки, но и анализировать их причины, выделять закономерности и формулировать гипотезы. Однако такие подходы пока находятся на ранних стадиях разработки. Пока же современный ИИ остаётся инструментом, который оптимизирует заданные функции, но не способен к настоящему обучению — тому, что делает человека разумным.
Подписаться
Уведомления о новых комментариях пока не подключены.
Пожалуйста, войдите, чтобы прокомментировать
0 комментариев